實操案例,帶你了解如何關聯分析
作者: 永洪BI??來源: 永洪科技??時間:2022年06月30日
前幾天,朋友問了我一個問題,大概是說,他們正在做一個大數據相關的分析,場景類似這樣,每天有大量的酒店入住人的信息,怎么從這些信息中,篩選出某幾個人是可能存在某種特定關系的。
(因為真實場景需要保密,所以這里采用類比的方式舉例,但是并不妨礙進行進一步的分析。)
聽完需求后,我的第一反應就是使用關聯規則的算法就可以實現想要得結果。
為了方便朋友理解,我使用Yonghong Desktop軟件做了一個案例。
首先準備測試數據。
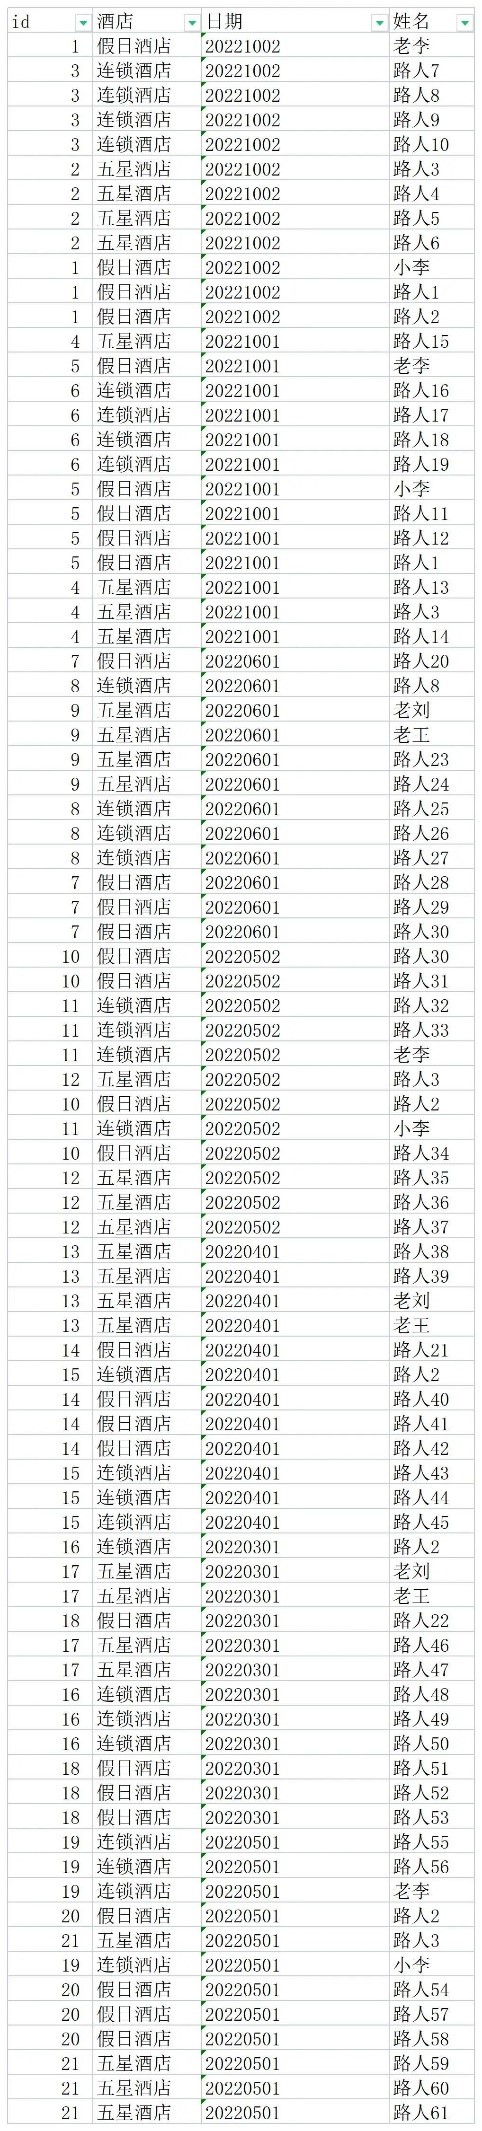
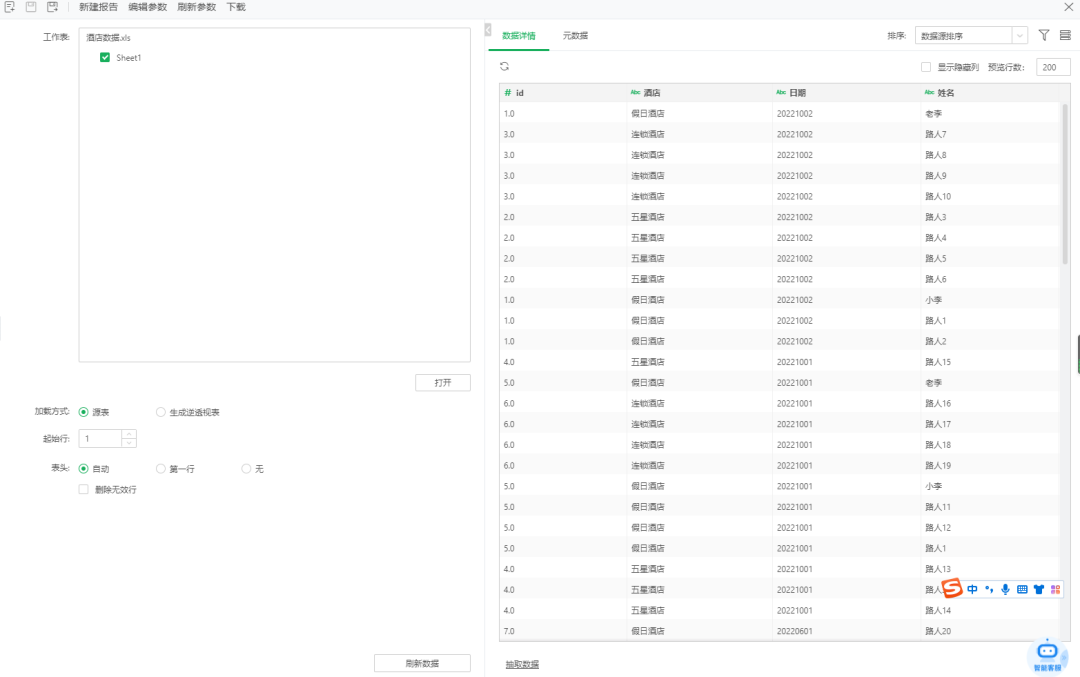
該數據中,同一個酒店和同一個日期入住的人,我們認為屬于同一個批次,給與相同的ID進行標識。然后上傳到Yonghong Desktop保存為數據集。
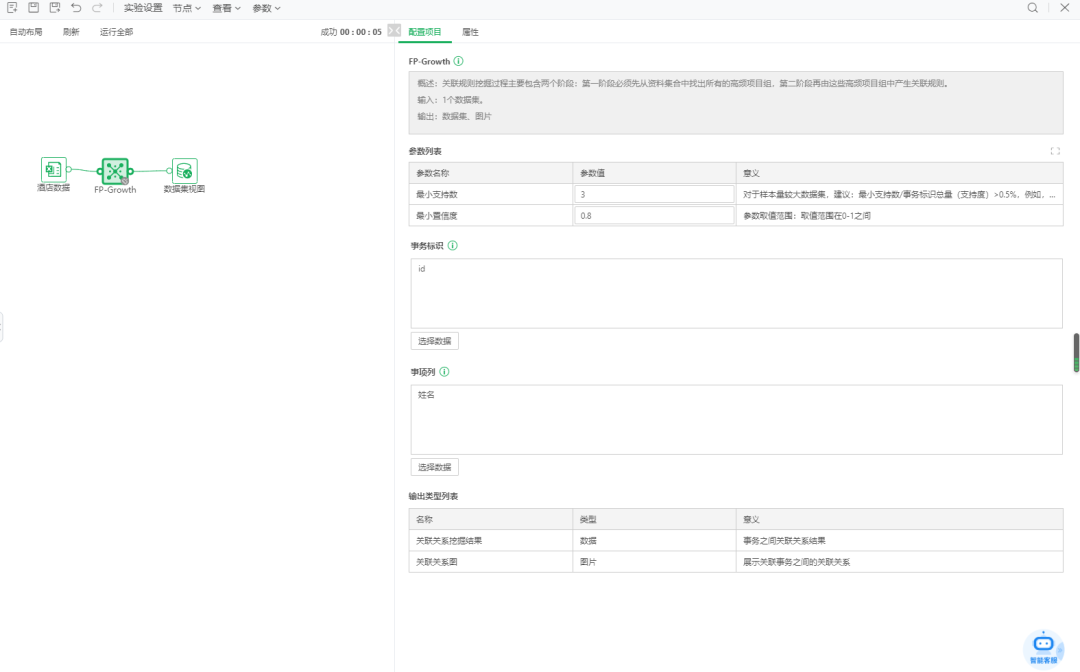
再在深度分析模塊新建實驗模型,拖入創建好的數據集,再拖入關聯規則算法,設置最小支持數和最小置信度,最后再拖入數據集視圖。至此,模型建立完畢。是不是特別簡單。
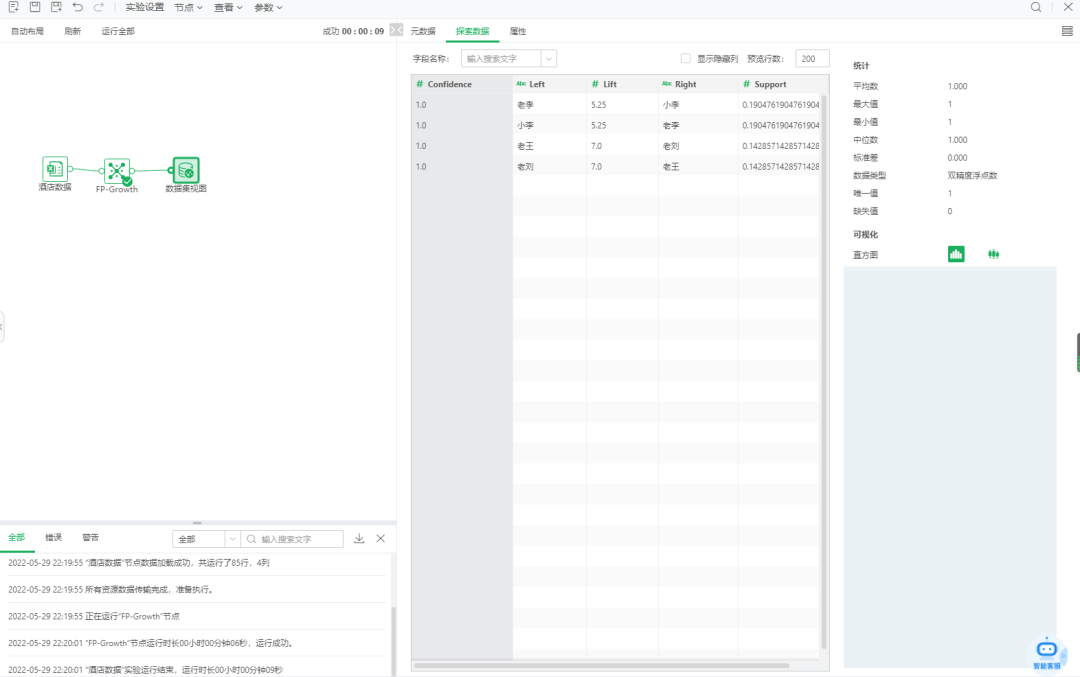
我們運行一下,幾秒后遍得到了結果,是不是很驚喜,so easy。
不過接下來就是朋友的四連問。
1:這個結果怎么看?
2:數據維度為什么只有這幾個,加幾個行嗎?
3:數據量大的話,怎么處理?
4:篩選出來的結果集比較大,怎么進一步提取關聯結果?
第一個問題
置信度,left 和right, 當 left出現時,right出現的概率,為置信度。
Support 為 left和right ,同時出現的概率,受整體樣本行數影響,這個值可能不會太高。最小支持數,數據重復出現的最小次數。
這里我們需要研究的是某人或者某些人之間的關聯關系,所以首先置信度要高,再者,left和right一定有關系的話,還必須是充分且必要,也就是說老李出現時,小李一定出現,反之小李出現時,老李一定出現,則我們可以認定他倆存在某種特定的關系。
第二個問題
我們研究的目的是找出可能存在的特定關系,在這個案例中,我們并不關心任何因果關系,只關心概率,也就是說如果反復匹配出現,則認為存在關聯關系。所以其他維度可以不要,只要能夠標識清楚這個ID和姓名就足夠了。
第三個問題
這里需要說回關聯規則的一個基本概念,頻繁項集,也就是說如果只出現1次,那么他肯定不能算頻繁項集。所以數據處理的時候可以直接排除掉只出現1次記錄。
最后一個問題,將結果集導入MySQL,再進行SQL處理,表1和表2相同,where 表1.left=表2.right and 表1.right = 表2.left,因為樣本數據較少,這里沒有做驗證。但是理論上應該可以行。
到這里是不是就結束了呢,其實,研究他們的關系還不是最終目的。
這里我提出1種假設,,找出了特定關系的數據后,還不知道它們是哪種特殊關系,怎么辦,以本案例來講,老李和小李,出現的時間是五一和國慶,所以他們大概率是一家人,是出來旅游的,那么就可以有針對性的推旅游線路,酒店,美食,特產相關的信息,也就是精準營銷。
至于應該怎么來猜,這里需要回歸到第二問題中,把數據放回多維度記錄中,去找比較突出的維度(也可以是打標簽),或者使用聚類分析(數據多的時候),然后再進行業務解析,這里做聚類和業務解析可能需要下次有機會再進一步展開了。
?